Ein Modell pro Schritt: warum KI Agenten mehr als ein Modell brauchen
Jeden Agentenschritt auf demselben Spitzenmodell laufen zu lassen, ist das teuerste Setup. Warum ein Modell pro Schritt Kosten senkt und Qualität hebt.
 Leopold zu Schleswig-HolsteinCEO, Kadmo
Auf dieser Seite 7 Abschnitte
Die meisten Teams, die mit Coding Agenten anfangen, nehmen das beste Modell, das sie bekommen, und lassen alles darauf laufen. Das fühlt sich sicher an. In der Praxis ist es vor allem teuer, und oft nicht einmal besser. Die Frage ist nicht, welches Modell das beste ist, sondern welches Modell für diesen Schritt das beste ist.
Was ein Modell pro Schritt heißt
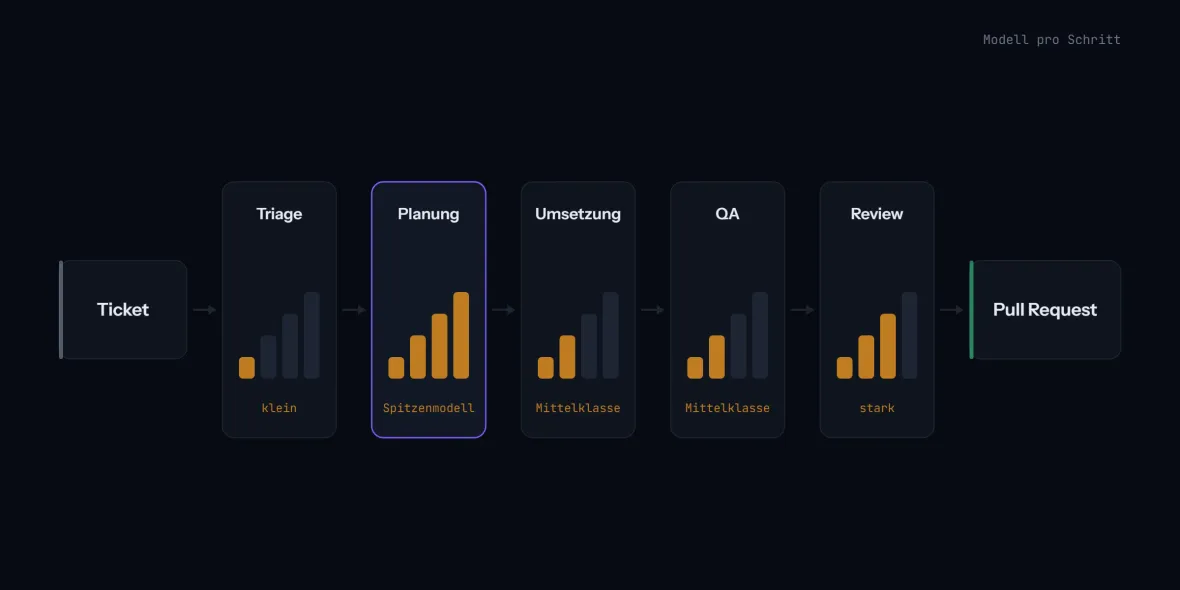
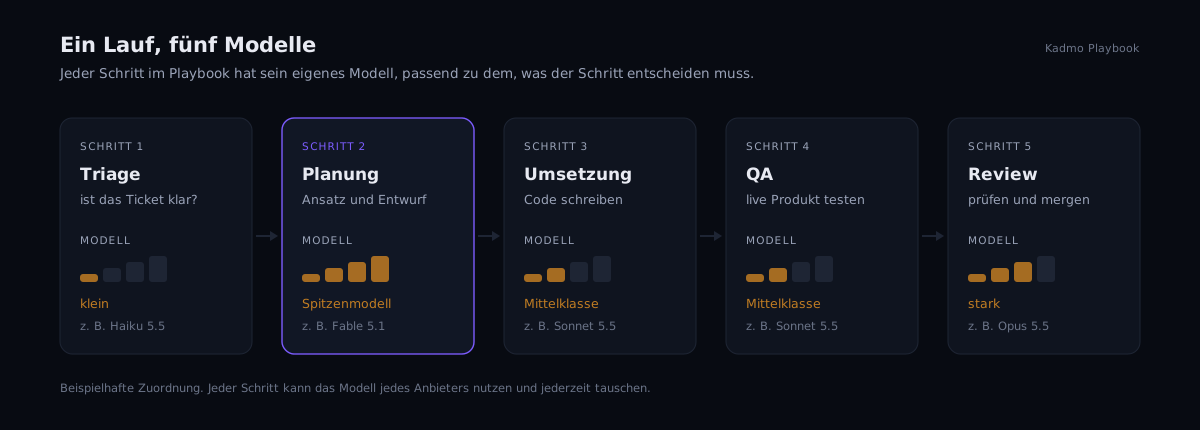
Ein Agent Workflow ist keine einzelne Aufgabe. Auf dem Weg vom Ticket zum Pull Request stecken ein Dutzend kleinere Arbeiten: das Ticket lesen und entscheiden, ob es klar genug ist, die Änderung planen, den Code schreiben, ihn gegen das laufende Produkt testen, ihn reviewen, die Übergabe schreiben. Jede dieser Arbeiten hat einen anderen Zuschnitt. Manche sind Ermessensfragen mit drei möglichen Antworten. Manche verlangen, eine ganze Codebasis im Blick zu behalten. Manche sind vor allem Tipparbeit.
Ein Modell pro Schritt heißt, dass jede dieser Arbeiten das Modell bekommt, das zu ihr passt. In einem Playbook hat jeder Schritt ohnehin seine eigene Rolle, seinen eigenen Eingang und sein eigenes Gate. Ein eigenes Modell ist der naheliegende nächste Schritt: Die Triage läuft auf einem kleinen, schnellen Modell, der Architekturplan auf dem stärksten verfügbaren, die Umsetzung auf einem starken Coding Modell, die Prüfung auf einem Modell, das gut liest und vergleicht.
Der Vergleich mit menschlichen Teams trägt auch hier. Niemand lässt die Principal Engineerin den Posteingang sortieren, und niemand lässt den neuesten Kollegen das Datenmodell entwerfen. Gute Teams verteilen Arbeit danach, was sie braucht, nicht danach, wer am meisten beeindruckt.
Warum das Ergebnis besser wird
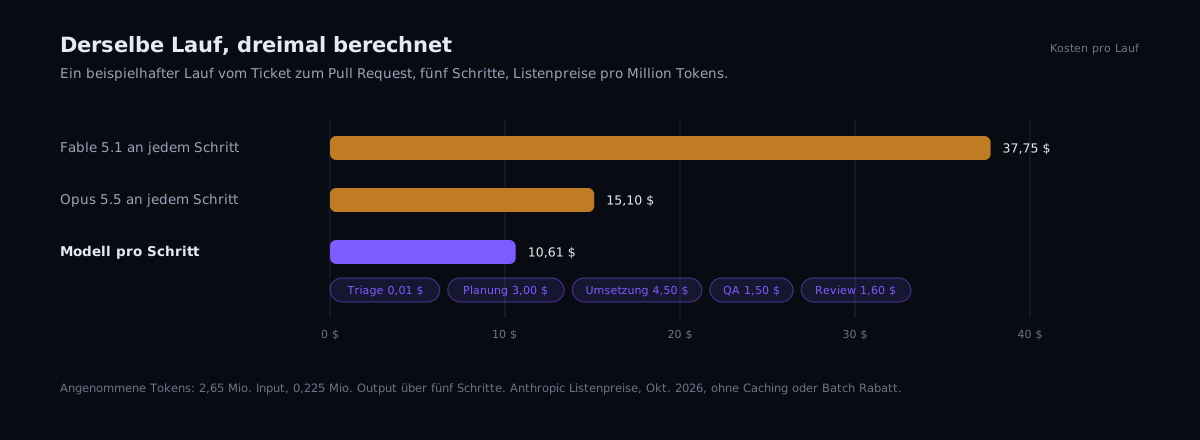
Die Preisspanne ist riesig. Die Listenpreise der aktuellen Modelle eines einzigen Anbieters liegen zwei Größenordnungen auseinander. Bei Anthropic kostet Haiku 5.5 10 Cent pro Million Input Tokens, Fable 5.1 kostet 10 Dollar. Zwischen Anbietern ist der Abstand noch größer. Ein Schritt, der hundertmal am Tag auf der falschen Klasse läuft, ist die Stelle, an der ein Agentenbudget unbemerkt verschwindet.
Kleine Entscheidungen brauchen kein langes Nachdenken. Ist dieses Ticket ein Bug oder ein Feature? Berührt der Diff das Zahlungsmodul? Ist die Testausgabe ein pass? Das sind Klassifikationsfragen. Ein kleines Modell beantwortet sie in einem Bruchteil der Zeit, und in einem Ablauf mit vielen solchen Fragen summiert sich die Wartezeit genauso wie die Kosten.
Starke Modelle kommen dorthin, wo es zählt. Das Budget, das nicht in die Triage fließt, steht für die Schritte bereit, in denen Qualität alles entscheidet: den Plan, der die Richtung vorgibt, und das Review, das entscheidet, ob Code in Produktion geht. Es geht nicht darum, an jedem Schritt zu sparen. Es geht darum, dort auszugeben, wo es etwas bringt.
Kleiner Kontext, schärfere Antworten. Ein Schritt mit eigenem Modell hat auch seinen eigenen Kontext. Chroma hat 2025 achtzehn Sprachmodelle getestet: Ihre Zuverlässigkeit sinkt mit wachsendem Input, selbst bei einfachen Aufgaben. Ein Modell, das nur sieht, was sein Schritt braucht, antwortet verlässlicher als eines, das den gesamten Lauf mit sich herumträgt.
Drei Punkte, die in solchen Vergleichen meistens fehlen
Ein gescheiterter Schritt kostet, was sein Modell kostet. Stoppt ein Gate einen Schritt, läuft der Schritt erneut. Auf einem kleinen Modell kostet eine Wiederholung Bruchteile eines Cents. Auf dem teuersten Modell machen Wiederholungen in Routineschritten aus einer planbaren Rechnung eine Überraschung. Die Aufteilung nach Modell hält Fehler dort billig, wo sie häufig sind.
Austauschen wird zur Konfiguration. Neue Modelle erscheinen alle paar Wochen. Läuft der ganze Ablauf auf einem Modell, ist ein Wechsel eine Migration mit Risiko an allen Schritten gleichzeitig. Hat jeder Schritt sein eigenes Modell, tauscht man es an einem Schritt, beobachtet dessen Gate eine Woche lang und macht weiter. Das Gate ist der Test, der zeigt, ob das neue Modell trägt.
Die Forschung zeigt schon länger in diese Richtung. FrugalGPT aus Stanford hat 2023 gezeigt, dass eine Kaskade von Modellen das beste Einzelmodell seiner Zeit bei bis zu 98 Prozent geringeren Kosten erreichen kann. RouteLLM von LMSYS hat 2024 berichtet, dass ein Routing zwischen starkem und schwachem Modell auf einem Benchmark 95 Prozent der Qualität des starken Modells hält, bei über 85 Prozent weniger Kosten. Beide verteilen einzelne Anfragen. Ein Playbook geht einen Schritt weiter, weil es vorher weiß, wofür jeder Schritt da ist.
Warum ein starkes Modell für alles nicht die sichere Wahl ist
Für ein einziges Modell spricht die Einfachheit. Ein Vertrag, ein Satz Eigenheiten, ein Promptstil, und die Beruhigung, dass jeder Schritt das Beste bekommt. Das Argument ist ernst zu nehmen. Ein schlecht gewähltes kleines Modell an einem Schritt, der Urteilsvermögen braucht, richtet echten Schaden an, und ein Setup mit fünf Modellen will mehr im Blick behalten werden als eines mit einem.
Die Antwort: Die Sicherheit kommt von den Gates, nicht vom Modell. Auch ein starkes Modell an jedem Schritt macht Fehler, nur teurer, und man bemerkt sie später. Ein kleines Modell hinter einem Gate, das sein Ergebnis prüft, ist sicherer als ein großes ohne Gate. Und der Aufwand mehrerer Modelle entsteht nur, wenn jeder Schritt von Hand eingerichtet werden muss. In einem Playbook ist das Modell ein Feld des Schritts, neben seiner Rolle und seinem Gate.
Was wir dabei gelernt haben
Die Schritte, in denen ein kleineres Modell gut abschneidet, sind selten die, auf die man zuerst tippt. Klassifikation und Routing liegen auf der Hand. Weniger offensichtlich: einen Lauf zu einer Übergabe zusammenzufassen oder einen Pull Request gegen die Akzeptanzkriterien seines Tickets zu prüfen. Beides sieht nach einem starken Modell aus und braucht oft keines, solange der Input sauber ist.
Umgekehrt gilt es auch. Der Schritt, der am häufigsten das stärkste Modell verdient, ist die Planung, nicht das Coding. Ein guter Plan macht die Umsetzung kürzer und lässt ein Mittelklassemodell den Code schreiben. Ein schwacher Plan macht aus dem fähigsten Coding Modell einen teuren Weg, das Falsche zu bauen.
Wo man anfängt
Nicht den ganzen Ablauf auf einmal umbauen. Man wählt einen Schritt mit hohem Volumen, der mit einer kurzen, prüfbaren Antwort endet, meistens ist das die Triage, und lässt eine Woche lang ein kleines Modell neben dem bisherigen mitlaufen. Am Gate vergleicht man die Antworten. Hält das kleine Modell, stellt man diesen Schritt um und nimmt sich den nächsten vor.
Bei Kadmo arbeiten spezialisierte Agenten nach Playbooks, in denen jeder Schritt sein eigenes Modell hat, von jedem Anbieter und jederzeit austauschbar. Weil jeder Schritt mit einem Gate endet, sehen Sie sofort, ob ein günstigeres Modell trägt. Wenn Sie sehen wollen, wie das bei Ihnen aussehen kann, zeigen wir es Ihnen gern.
Quellen
- https://claude.com/pricing
- https://www.trychroma.com/research/context-rot
- https://arxiv.org/abs/2305.05176
- https://lmsys.org/blog/2024-07-01-routellm/