Zum Inhalt springen

Eine OpenAI Alternative mit dem richtigen Modell für jeden Schritt.

Eine schnelle Einordnung, ein Umsetzungsplan und ein abschließendes Review verlangen Verschiedenes von einem Modell. Mit Kadmo wählt Ihr Software-Team für die Arbeit jedes Schritts unterstützte Modelle von OpenAI, Anthropic und seinen anderen konfigurierten Anbietern.

Behalten Sie den Workflow, bewerten Sie das Ergebnis und ändern Sie eine Modellzuweisung, wenn eine andere Option der Aufgabe besser dient. Kadmo bringt diese Wahl in seine Chats, Agenten und unterstützte externe Clients, über eine API im Anthropic-Messages-Format.

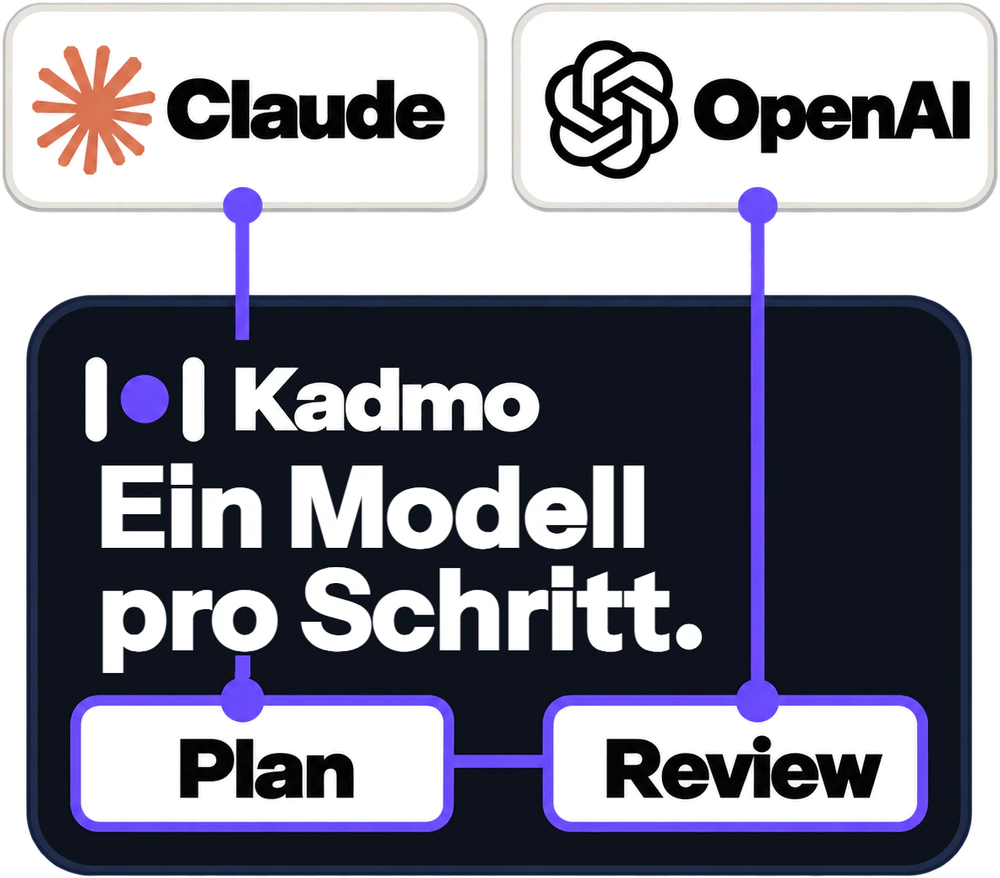
Zwei Kacheln, Claude und OpenAI, führen über violette Linien zu einer dunklen Kadmo-Karte, Ein Modell pro Schritt: Claude zum Schritt Plan, OpenAI zum Schritt Review.

Beginnen Sie mit dem, was der Schritt richtig machen muss.

Angenommen, ein Bugfix-Prozess beginnt damit, eine Meldung einzuordnen, untersucht dann die Ursache, setzt eine Änderung um und prüft sie. Die Einordnung braucht eine klare Antwort in bekanntem Format. Die Untersuchung braucht genug Schlussfolgerung, um eine Ursache von einem Symptom zu unterscheiden. Das Review muss die Änderung am beabsichtigten Verhalten messen.

Diese Anforderungen geben Ihnen eine Grundlage für die Modellwahl. Ein kleineres Modell deckt den ersten Schritt vielleicht ab. Ein leistungsfähigeres Modell verdient seine Kosten vielleicht in der Untersuchung. Messen Sie jedes an den Belegen, die der nächste Schritt braucht.

Verschiedene Modellfamilien in einem Workflow.

Ein Kadmo-Playbook kann jedem Agentenschritt ein Modell zuweisen. Die Planung kann Claude nutzen, während ein anderer Schritt GPT nutzt; Rollen, Berichte und Akzeptanzbedingungen bleiben Teil des Prozesses.

Ihre Wahl kommt aus den Modellen, die über Ihre konfigurierten Anbieterrouten und Ihren Plan verfügbar sind. Sie können OpenAI für die Arbeit behalten, die es gut erledigt, und einen anderen Anbieter dort einführen, wo er hilft, mit einem klaren Grund für jede Zuweisung.

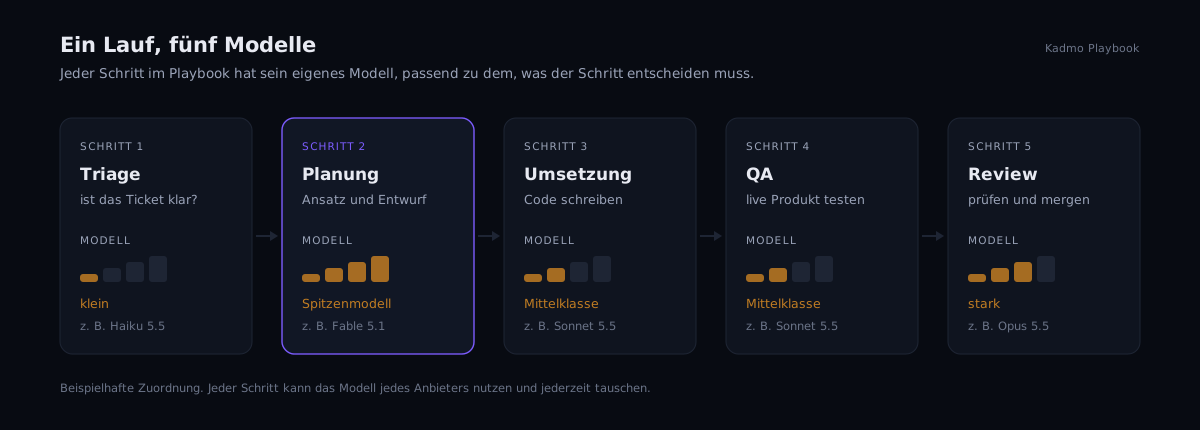
Ein Playbook-Lauf in fünf Schritten, jeder mit eigenem Modell: ein kleines Modell für die Einordnung, das stärkste für den Plan, Modelle der mittleren Klasse für Umsetzung und QA und ein starkes Modell für das Review.

OpenAI-Modelle, mit der Wahl der Coding-CLI.

Claude Code mit Claude Code Router

OpenAI-Modelle · Geroutete Coding-CLI

Nutzen Sie OpenAI-Modelle aus Claude Code über Claude Code Router. Claude Code liefert die Coding-Umgebung; der Router verbindet seine Modellanfragen mit OpenAI. Ein Team, das mit Claude Code arbeitet, bekommt so eine unterstützte Route zu GPT für Agentenarbeit.

Codex

OpenAI-Modelle · Unterstützte Agent-CLI

Lassen Sie Codex als Coding-CLI auf einem Kadmo-Agenten mit OpenAI-Modellen laufen. Geben Sie dem Agenten Arbeit über Kadmo, folgen Sie seiner Ausführung und prüfen Sie sein Ergebnis im Lieferprozess Ihres Teams. Wählen Sie dieses Setup, wenn Codex die Coding-Umgebung ist, die Sie betreiben wollen.

Ändern Sie eine Zuweisung, dann prüfen Sie das Ergebnis.

Probieren Sie ein Kandidatenmodell an einem begrenzten Schritt aus, bevor Sie einen ganzen Prozess umstellen. Nutzen Sie eine repräsentative Aufgabe und dieselben Akzeptanzbedingungen. Prüfen Sie die Ausgabe, das Verhalten mit Werkzeugen, die benötigte Zeit und die Modellkosten.

Das konfigurierte Modell zu ändern belegt nicht, dass sein Verhalten gleichwertig ist. Vielleicht müssen Sie Anweisungen anpassen oder die Art, wie ein Schritt Werkzeuge nutzt. Kadmo hält den Prozess explizit, damit das Team eine Änderung an der Arbeit messen kann, die sie erledigen muss.

Sehen Sie, wohin die Modellkosten gegangen sind.

Kadmo berechnet Modellaufrufe nach Eingabe- und Ausgabenutzung, in Euro, nach seiner aktuellen Preisliste. Die Abrechnung zeigt Ausgaben nach Workspace, Modell und Art der Arbeit; Threads und Jobs lassen sich zur näheren Prüfung öffnen.

Nutzen Sie diese Aufzeichnung, um einen teuren Lauf zu verstehen. Eine Untersuchung rechtfertigt vielleicht ein größeres Modell; eine wiederkehrende Prüfung ist ein Kandidat für ein kleineres. Der nützliche Vergleich sind die Kosten eines Ergebnisses, das die Anforderungen des Schritts erfüllt, einschließlich der Nacharbeit, die es brauchte.

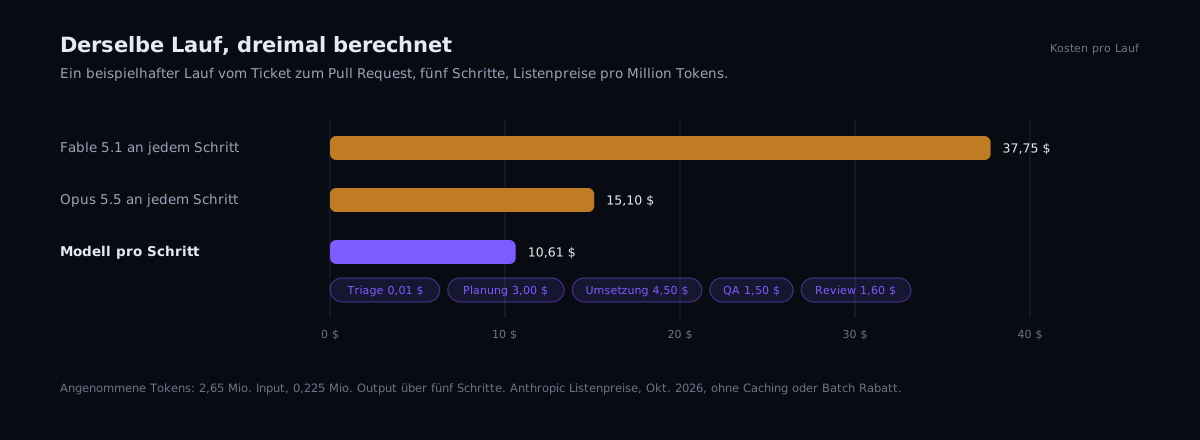
Die Kosten eines beispielhaften Laufs, dreimal berechnet: jeder Schritt auf dem stärksten Modell, jeder Schritt auf einem Modell der mittleren Klasse, und ein Modell pro Schritt.

Setzen Sie das Modellbudget, bevor die Arbeit beginnt.

Für Aufrufe, die Kadmo bedient, wird Guthaben zurückgelegt, bevor die Anfrage läuft, und danach mit der tatsächlichen Nutzung verrechnet. Agenten-Jobs reservieren ihre geschätzten Modellkosten und pausieren, wenn die Reservierung aufgebraucht ist.

Admins können außerdem monatliche oder Gesamtbudgets für das Konto oder einen Workspace setzen. Eine Grenze gibt dem Team einen Entscheidungspunkt: Guthaben nachlegen, das Budget überarbeiten oder die Arbeit ändern. Die Ablehnung oder Pause erklärt, was Aufmerksamkeit braucht.

Rechnen Sie mit den Kosten rund um das Modell.

Modellguthaben ist ein Teil des Ganzen. Der Plattformplan und die Maschinenzeit gehosteter Agenten sind getrennte Kosten. Aufrufe mit Ihren eigenen Anbieterzugängen rechnet dieser Anbieter ab; Maschinen in Ihrer Cloud rechnet Ihr Cloud-Anbieter ab.

Eine Pause wegen der Modellkosten schaltet keine bezahlte Maschine ab. Rechnen Sie ihre Laufzeit ein, wenn Sie die Kosten eines Workflows bewerten, und wählen Sie die Hosting- und Anbieter-Anordnung, die zu Ihrem Team passt.

Wenn der direkte Zugang zu OpenAI besser passt.

Nutzen Sie den direkten Zugang zu OpenAI, wenn Ihre Anwendung von OpenAI-spezifischen APIs, nativen Funktionen oder einer Anbieterbeziehung abhängt, die Sie selbst führen wollen. Kadmo ist besonders nützlich, wenn die Modellwahl in der Engineering-Arbeit eines Teams liegt und über Anbieter hinweg änderbar bleiben soll.

Kadmo bietet außerdem eine LLM-API für unterstützte externe Clients. Sie nutzt das Anthropic-Messages-Format mit den Kadmo-Zugangsdaten eines Mitglieds. Eine Anwendung, die OpenAIs Responses- oder Chat-Completions-Format nutzt, braucht eine passende Integration; der Endpunkt ist kein Drop-in-Ersatz für diese APIs.

Wenn die Hauptentscheidung ist, wer eine Anfrage überhaupt erhalten darf, lesen Sie über Anbieter- und Datenkontrolle auf der Seite zur Anthropic Alternative.
Fragen zu Modellen und Kosten.

Können wir GPT weiter nutzen?

Ja. Anbieterunabhängigkeit schließt ein, OpenAI-Modelle dort zu behalten, wo sie zur Aufgabe passen. Ihr Team kann andere unterstützte Modelle Schritt für Schritt einführen, statt jede Zuweisung auf einmal zu ersetzen.

Kann ein günstigeres Modell eine Aufgabe teurer machen?

Ja. Mehr Versuche, längere Ausgaben oder zusätzliches Review können einen niedrigeren Token-Preis aufwiegen. Vergleichen Sie die Kosten bis zu einem akzeptablen Ergebnis, einschließlich Nacharbeit, bevor Sie einen Routineschritt auf ein kleineres Modell umstellen.

Bleibt ungenutztes reserviertes Modellguthaben ausgegeben?

Nein. Eine Reservierung legt Guthaben für Arbeit zurück. Berechnet wird die tatsächliche Nutzung, und ungenutztes reserviertes Guthaben wird bei der Abrechnung der Reservierung wieder frei. Die Abrechnung unterscheidet reserviertes Guthaben vom Betrag, der für den Start anderer Arbeit verfügbar ist.

Wo entscheiden wir, welche Anbieter erlaubt sind?

Die freigegebenen Modelle, Anbieterverbindungen und geltenden Regionenregeln Ihres Kontos bestimmen die Auswahl. Die Seite zur Anthropic Alternative behandelt diese Anbieter- und Datenkontrollen.

Ordnen Sie Ihren ersten Workflow einem Modellbudget zu.

Bringen Sie einen Prozess mit, den Ihr Team schon ausführt. Legen Sie fest, was jeder Schritt liefern muss, wählen Sie Kandidatenmodelle und vereinbaren Sie die Ausgabe und die Ausgaben, die Sie akzeptieren. Beginnen Sie mit einer Änderung, die Sie bewerten können.