Harvard Studie: Coding Agenten liefern mehr Code, aber nicht mehr Software
Coding Agenten steigern den Code Output um 30 Prozent, die gelösten Tickets bleiben gleich. Eine Harvard Studie zeigt, warum das Review zum Engpass wird.
 Leopold zu Schleswig-HolsteinCEO, Kadmo
Auf dieser Seite 5 Abschnitte
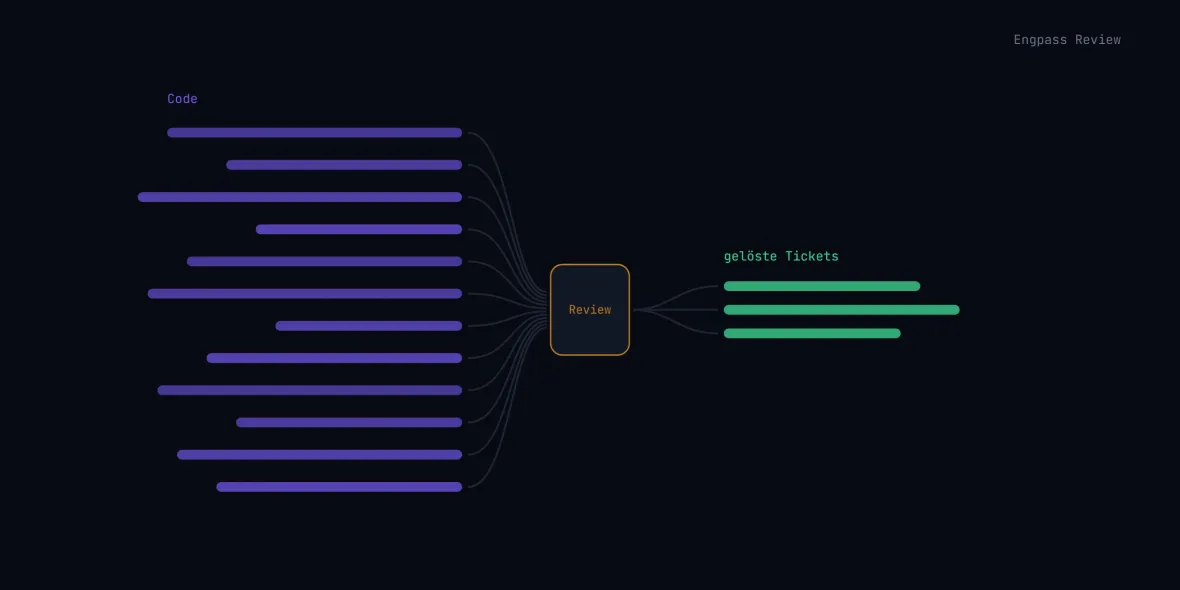
Seit Mitte Oktober macht ein Working Paper aus Harvard die Runde, und es bestätigt, was viele Engineering Leads schon ahnen. Teams, die Coding Agenten einsetzen, schreiben rund 30 Prozent mehr Code. Sie lösen nicht mehr Tickets. Der zusätzliche Code staut sich im Review, wo er länger wartet und öfter zurückgeht. Für alle, die Agenten in echten Teams einsetzen, ist das die bislang nützlichste Studie des Jahres.
Was die Studie gefunden hat
Fiona Chen und James Stratton, zwei Forschende in Harvard, haben mit Daten von Jellyfish gearbeitet, einer Plattform für Engineering Analytics. Ihre Stichprobe umfasst 718 Unternehmen und rund 726.000 Beschäftigte von Januar 2021 bis März 2026, etwa 300 Millionen Ereignisse aus GitHub, Jira und Kalendern. Weil die Unternehmen KI Werkzeuge zu unterschiedlichen Zeitpunkten eingeführt haben, konnten die Autoren jedes Unternehmen vor und nach der Einführung mit denen vergleichen, die noch nicht umgestellt hatten.
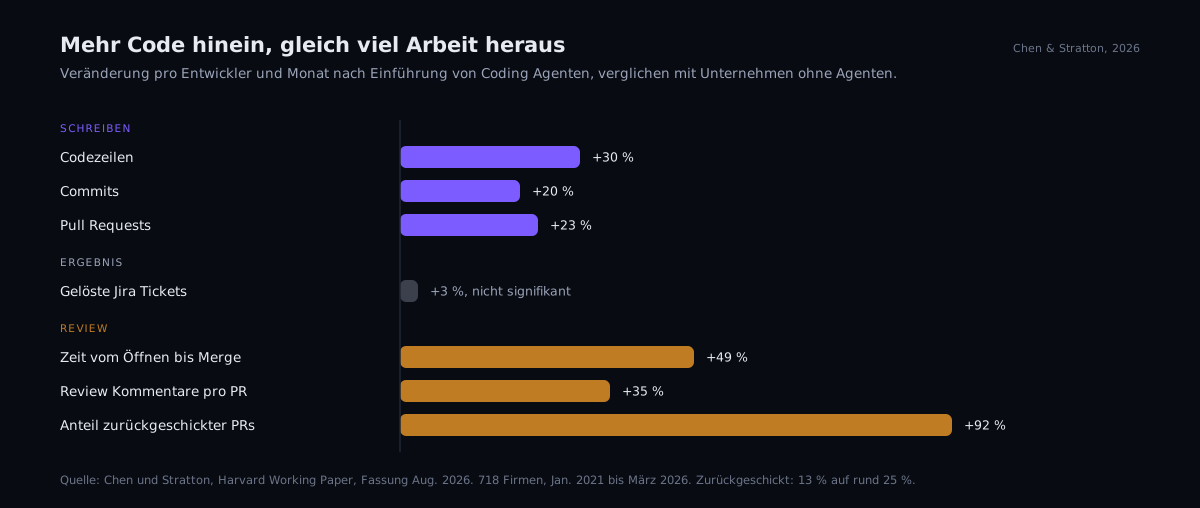
Beim Schreiben hat sich deutlich etwas bewegt. Nachdem ein Unternehmen Coding Agenten wie Claude Code oder den Agenten von Cursor eingeführt hatte, schrieb jeder Entwickler pro Monat rund 1.500 Zeilen Code mehr, ein Plus von 30 Prozent. Die Commits stiegen um 20 Prozent, die Pull Requests um 23 Prozent. Einfache Code Assistenten ohne Agentenmodus zeigten deutlich kleinere Effekte.
Beim Ergebnis hat sich nichts bewegt. Gelöste Jira Tickets und abgeschlossene Epics zeigten keine signifikante Veränderung, und die Schätzungen schließen ein Plus von mehr als 12 Prozent aus. Auch die Größe der Tickets blieb gleich, die Teams haben also nicht einfach größere Aufgaben angepackt. Die Beschäftigung blieb ebenfalls unverändert.
Wo die Arbeit hängen bleibt
Die Lücke zeigt sich im Review. Nach Einführung der Agenten stieg die Zeit vom Öffnen eines Pull Requests bis zum Merge um 3,45 Tage, 49 Prozent über dem Ausgangswert von etwa einer Woche. Der Anteil der Pull Requests, die zur Überarbeitung zurückgingen, hat sich fast verdoppelt, von 13 auf rund 25 Prozent. Die Kommentare pro Pull Request stiegen um 35 Prozent, obwohl die Pull Requests nicht größer wurden. Und 14 Prozent mehr Entwickler wurden ins Review gezogen.
Die Autoren beschreiben zwei Stufen, Schreiben und Prüfen. Agenten beschleunigen die erste. Solange die zweite an derselben menschlichen Zeit hängt, verschiebt schnelleres Schreiben nur die Warteschlange. Dazu deutet der höhere Anteil zurückgeschickter Pull Requests auf ein zweites Problem: Ein Teil des Agentencodes braucht mehr Korrektur, als menschlicher Code es tat. Das erste Problem lässt sich lösen, indem man Leute ins Review verlagert, so die Autoren. Für das zweite braucht es bessere Werkzeuge.
KI Review ist noch nicht der Ausweg, zumindest nicht so, wie die meisten Teams es heute nutzen. Bis März 2026 hatten fast 80 Prozent der Unternehmen KI Review Werkzeuge im Einsatz, doch diese schrieben nur 23 Prozent der Review Kommentare und tauchten in etwa jedem zehnten Pull Request auf. In dieser Stichprobe blieb Review menschliche Arbeit.
Worauf man nüchtern schauen sollte
Es handelt sich um ein Working Paper, noch ohne Peer Review. Die Daten stammen von Jellyfish Kunden, die der Forschungsnutzung zugestimmt haben, also eher von Unternehmen, die ihr Engineering genau messen. Die Einführung wird pro Unternehmen gemessen, nicht pro Person, der Effekt auf einzelne Entwickler ist daher vermutlich größer als die Durchschnittswerte.
Die Review Zahl misst die verstrichene Zeit vom Öffnen bis zum Merge, nicht die Stunden aktiver Prüfung. Ein Pull Request, der drei Tage in der Warteschlange liegt, zählt genauso wie einer, der drei Tage Arbeit kostet. Und der Beobachtungszeitraum endet im März 2026. Agenten und Review Werkzeuge haben sich seitdem stark verändert, die Größe des Effekts kann heute also schon anders aussehen.
Unabhängig davon gilt die Richtung: Mehr generierter Code wird nicht von selbst zu mehr fertiger Arbeit. Er wird zu mehr, das geprüft werden muss.
Was das für Teams heißt
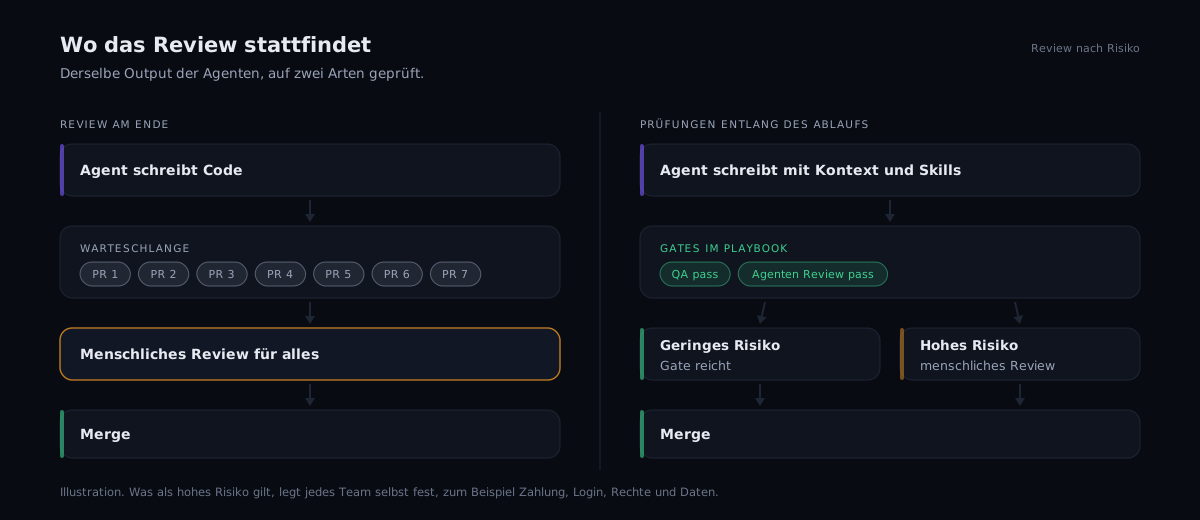
Die Studie trifft eine stille Annahme, die man hinterfragen sollte: dass jede Änderung dasselbe menschliche Review braucht. So arbeiten die meisten Teams heute, und genau das macht aus mehr Code eine längere Warteschlange.
Die Alternative ist, nach Risiko zu prüfen. Eine Änderung am Bezahlablauf, am Login oder eine Datenmigration verdient ein sorgfältiges menschliches Review. Eine Textänderung, ein Dependency Update oder ein Test für eine bestehende Funktion nicht, solange ein Agent sie gegen das Ticket geprüft und das Gate sie durchgelassen hat. Wie tief ein Review geht, sollte davon abhängen, was ein Fehler an dieser Stelle kostet, nicht davon, wer den Code geschrieben hat.
Der zweite Hebel ist der Anteil der Arbeit, der überhaupt im Review scheitert. In der Studie hat er sich fast verdoppelt. Oft ist das, was zurückgeht, nichts Exotisches: Der Agent hat eine Konvention übersehen, das Ticket falsch gelesen oder nicht gewusst, wie ein Modul gedacht ist. Das ist eine Frage des Kontexts: Ein Agent, der die Codebasis, ihre Regeln und ihre Fallstricke kennt und nur sieht, was sein Schritt braucht, produziert weniger, das zurückgehen muss.
Wer auf die Studie reagieren will, fängt beim Messen an. Codezeilen und Commits sind die Zahlen, die gestiegen sind. Zeit bis zum Merge, Anteil zurückgeschickter Pull Requests und gelöste Tickets zeigen, ob man mehr ausliefert. Danach sortiert man die Pull Requests in zwei oder drei Risikoklassen und legt pro Klasse fest, wer prüft. Ein einfacher Anfang: Änderungen an Zahlung, Authentifizierung, Berechtigungen und Daten bekommen immer ein menschliches Review. Änderungen innerhalb eines Moduls mit guter Testabdeckung bekommen ein Agenten Review gegen das Ticket, dazu Stichproben durch Menschen. Alles andere geht allein über das Gate. Nach einem Monat vergleicht man den Anteil zurückgeschickter Pull Requests pro Klasse und verschiebt die Grenzen dort, wo die Zahlen es nahelegen.
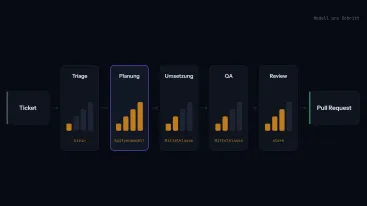
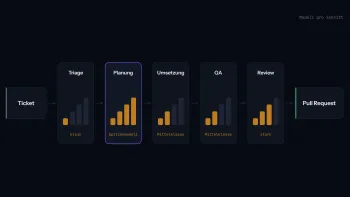
Bei Kadmo arbeiten spezialisierte Agenten nach Playbooks, in denen jeder Schritt mit einem Gate endet, gesetzt von einem Agenten oder einem Menschen, je nachdem was ein Fehler an dieser Stelle kostet. Die Agenten tragen das Wissen über Ihre Software in ihren Skills, deshalb scheitert weniger Arbeit im Review: 92,5 Prozent der Pull Requests unserer Agenten werden im menschlichen Review angenommen. Wenn Sie sehen wollen, wie das bei Ihnen aussehen kann, zeigen wir es Ihnen gern.
Quellen
- https://fion.ac/jellyfish.pdf
- https://www.byteherald.com/2026/10/ai-dev-productivity-is-25-50-not-10x.html
- https://dev.to/jamilxt/ai-agents-write-30-more-code-shipped-software-did-not-move-code-review-is-why-47ii
- https://forkast.news/ai-coding-agents-write-30-more-code-and-resolve-zero-additional-issues-harvard-study-finds/