TypeSafe Jev: ein Modell, das nur entscheidet
TypeSafe Jev beantwortet typisierte Fragen in rund 100 Millisekunden. Was das Modell kann, wo es scheitert und was es für Agent Workflows heißt.
 Leopold zu Schleswig-HolsteinCEO, Kadmo
Auf dieser Seite 5 Abschnitte
Am 15. September ist TypeSafe AI aus dem Stealth Modus gekommen, mit 40 Millionen Dollar Seed Finanzierung unter Führung von DCVC und einem ersten Modell namens Jev. Seitdem taucht es in fast jedem Entwicklerblog auf, obwohl es weder chatten noch Code schreiben kann. Für Teams, die mit KI Agenten arbeiten, ist es trotzdem eines der interessanteren Releases dieses Jahres.
Was Jev ist
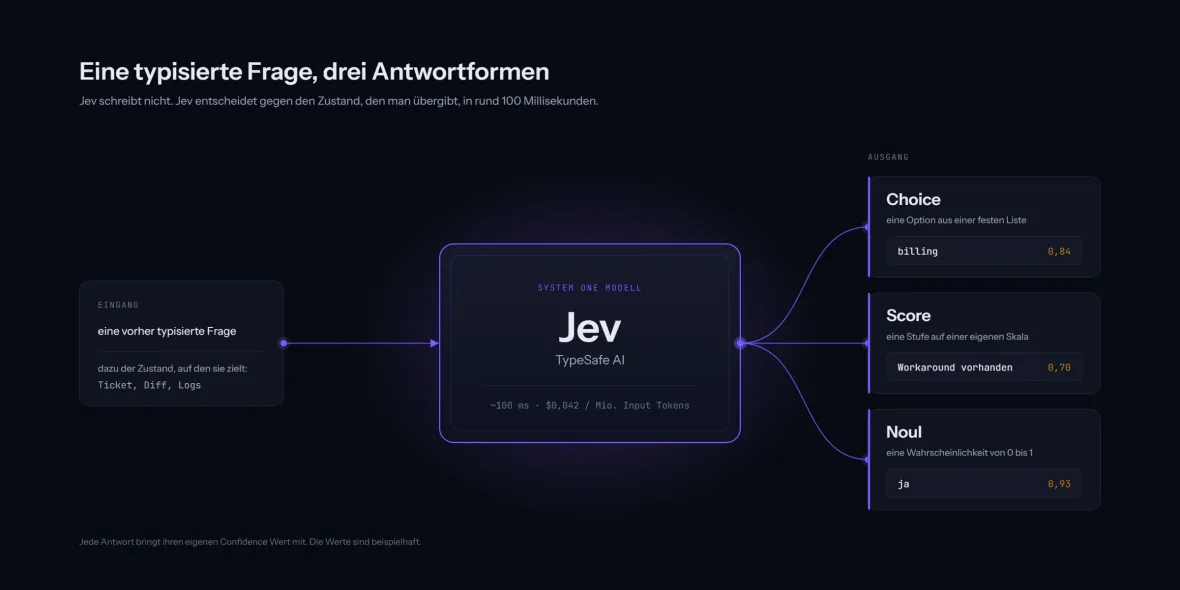
Hinter TypeSafe steht Diogo Almeida, der bei OpenAI an RLHF und InstructGPT mitgearbeitet hat, also an den Trainingsmethoden hinter ChatGPT. Jev ist bewusst kein Sprachmodell im üblichen Sinn. Man schickt ihm einen Zustand, etwa ein Ticket, eine Logzeile oder einen Shell Befehl. Dazu kommt eine Liste von Fragen mit festgelegten Antwortformen. Davon gibt es drei: eine Ja/Nein Frage (bei TypeSafe „Noul“), eine Auswahl aus vorgegebenen Optionen („Choice“) und eine Einordnung auf einer Skala, deren Stufen man selbst beschreibt („Score“). Zurück kommt kein Text, sondern pro Frage eine Wahrscheinlichkeitsverteilung plus ein Konfidenzwert.
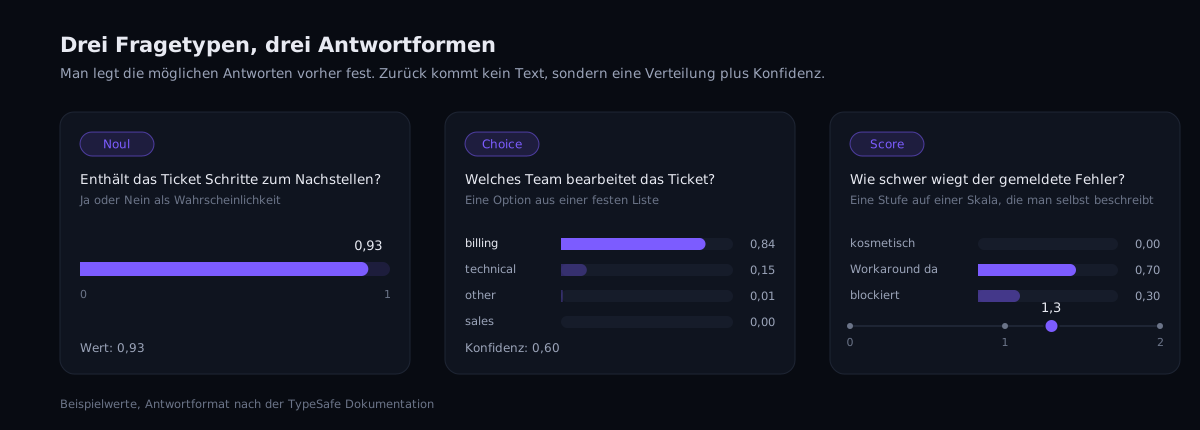
Flavio Copes beschreibt Jev in seinem ausführlichen Test als eine Art intelligentes if Statement. Normaler Code verzweigt auf Werte, die er berechnen kann. Sobald die Bedingung ein Urteil ist, etwa ob ein Befehl gefährlich ist oder ein Ticket genug Informationen enthält, brauchte man bisher ein großes Sprachmodell oder eine Regex, die bei jedem Sonderfall bricht.
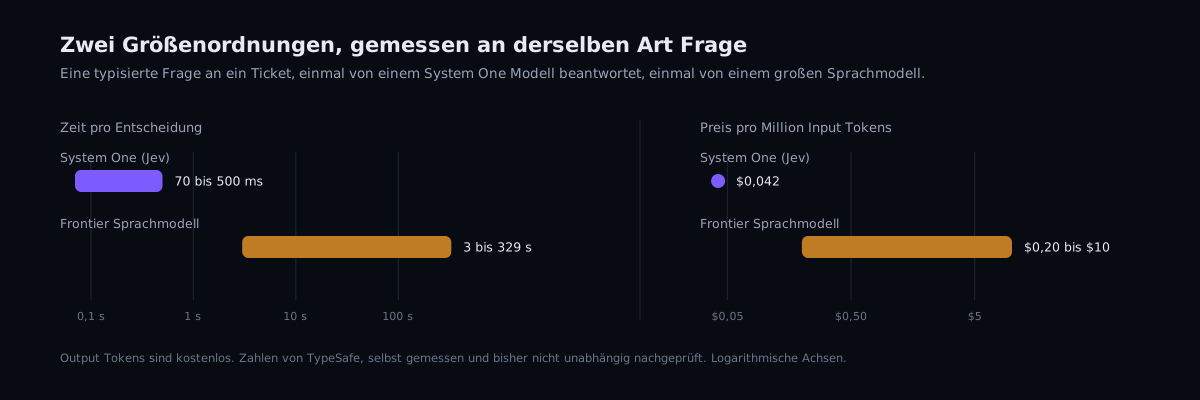
TypeSafe nennt folgende Eckdaten: Die meisten Aufrufe dauern rund 100 Millisekunden, Input kostet 0,042 Dollar pro Million Tokens und Output ist kostenlos. Alle Fragen zu einem Zustand werden parallel beantwortet, eine zusätzliche Frage verlängert die Antwortzeit also kaum. Trainiert wurde mit einem eigenen Verfahren namens Reinforcement Learning for Calibrated Decisions. Es soll dafür sorgen, dass eine Antwort mit 90 Prozent Wahrscheinlichkeit auch in etwa 90 Prozent der Fälle stimmt.
Wo so ein Modell in einem Agent Workflow sitzt
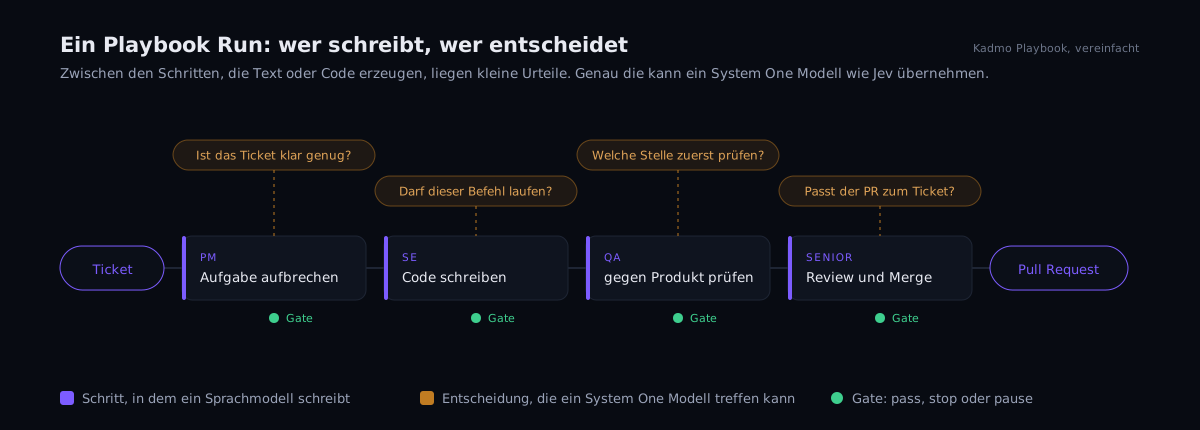
Ein Coding Agent trifft auf dem Weg vom Ticket zum Pull Request viele kleine Entscheidungen, die mit Schreiben nichts zu tun haben. Ist das Ticket klar genug, um loszulegen? Braucht die Aufgabe ein schnelles oder ein starkes Modell? Darf dieser Befehl ohne Rückfrage laufen? Passt der fertige Pull Request zu dem, was im Ticket stand? Heute beantwortet diese Fragen meist dasselbe große Modell, das auch den Code schreibt, mit entsprechender Wartezeit und entsprechenden Kosten.
Die ersten Integrationen zeigen, wohin das geht. LangChain hat zum Start eine Middleware veröffentlicht, die Anfragen per Jev an ein günstiges oder ein starkes Modell verteilt, dazu eine zweite, die Tool Aufrufe vor der Ausführung auf Risiko prüft. Bei Browser Use ist ein Agent entstanden, der auf Google Flights in gut sieben Sekunden einen Flug heraussucht, weil jeder Klick eine Auswahl aus nummerierten Seitenelementen ist und nur das Eintippen von Text noch ein Sprachmodell braucht. Andere haben Code Reviews in eine Risikomatrix pro Datei zerlegt, die Jev befüllt.
In all diesen Beispielen schreibt das Sprachmodell weiterhin den Text oder den Code. Jev entscheidet über den nächsten Schritt, während Schleife, Sicherheitsregeln und Rechenarbeit in normalem Code bleiben.
Was man nüchtern sehen sollte
Jev ist zwei Wochen alt. Direkt bei TypeSafe läuft der Zugang noch über eine Warteliste, ohne Wartezeit geht es über Vercels AI Gateway. Die Schlagzeilen mit fast 200 mal schneller und über 400 mal günstiger stammen aus TypeSafes eigenen Tests. TypeSafe selbst ordnet sie am oberen Ende der realen Ergebnisse ein. Auch der Genauigkeitsvergleich hat einen Haken: Es gibt keine unabhängige Grundwahrheit, gemessen wird die Übereinstimmung mit dem gemittelten Urteil zweier Frontier Modelle. Nachgemessen hat das von außen bisher niemand.
Die Aussage, Jev könne nicht halluzinieren, ist enger gemeint, als sie klingt. Das Modell kann keinen Wert außerhalb der vorgegebenen Optionen liefern, wohl aber die falsche erlaubte Option. TypeSafe dokumentiert außerdem offen, wo Jev schwach ist: Es zählt nicht zuverlässig, vergleicht Datumsangaben nicht sicher und liest Fragen sehr wörtlich. Bilder, Audio oder Video versteht es bisher nicht.
Was das für Teams heißt
Die eigentliche Nachricht steckt weniger im Modell selbst als in dem, was es über die Architektur von KI Systemen sagt. Der Entwickler Hassan El Mghari hat 1.018 Forschungspaper zusammenfassen und klassifizieren lassen. Die Zusammenfassungen durch ein Sprachmodell kosteten 3,99 Dollar, die Klassifikation mit Jev 8 Cent. Sein Schluss daraus: Künftig arbeiten für verschiedene Teile eines Workflows verschiedene Modelle, statt eines für alles.
Für Engineering Teams folgt daraus ziemlich direkt, wie ein gutes Setup gebaut sein sollte. Die Arbeit muss in klare Schritte zerlegt sein, sonst weiß niemand, an welcher Stelle eine schnelle Entscheidung reicht und wo ein starkes Modell nachdenken muss. Jeder Schritt braucht ein Ergebnis, das Code prüfen kann. Die Modelle müssen außerdem austauschbar sein, weil der nächste neue Modelltyp mit Sicherheit kommt, vermutlich schneller als gedacht.
Wer Jev ausprobieren will, fängt am besten mit einer einzigen unspektakulären Entscheidung an, die heute ein großes Modell oder eine fragile Regel trifft. Jev läuft zunächst nur mit und schreibt seine Antworten ins Log. Danach vergleicht ihr die Konfidenzwerte mit dem, was tatsächlich richtig war. Automatisiert wird zuerst der Fall, bei dem ein Fehler wenig kostet. Fragen und Schwellenwerte gehören dabei in eine gemeinsame Datei, weil das der Teil ist, den ein Mensch reviewen muss.
Bei Kadmo arbeiten spezialisierte Agenten nach Playbooks, in denen jeder Schritt mit einem Gate endet, also einem klaren Urteil pass, stop oder pause. Das Modell dahinter ist jederzeit austauschbar. In eine solche Struktur lassen sich neue Modelltypen wie Jev dort einsetzen, wo sie ihre Stärke haben. Wenn ihr sehen wollt, wie das bei euch aussehen kann, zeigen wir es euch gern.