Playbooks: warum feste Abläufe aus KI Agenten ein Team machen
Ein Playbook legt fest, welche Rolle welchen Schritt übernimmt und woran gemessen wird. Warum das die Qualität hebt und Tokens spart.
 Leopold zu Schleswig-HolsteinCEO, Kadmo
Auf dieser Seite 6 Abschnitte
Wer zum ersten Mal einen Coding Agenten auf ein Ticket loslässt, erlebt beides: erstaunlich gute Ergebnisse und Ausreißer, die hinterher niemand erklären kann. Der Unterschied liegt selten am Modell. Er liegt daran, ob der Agent einen Ablauf hat oder nur einen Auftrag.
Was ein Playbook ist
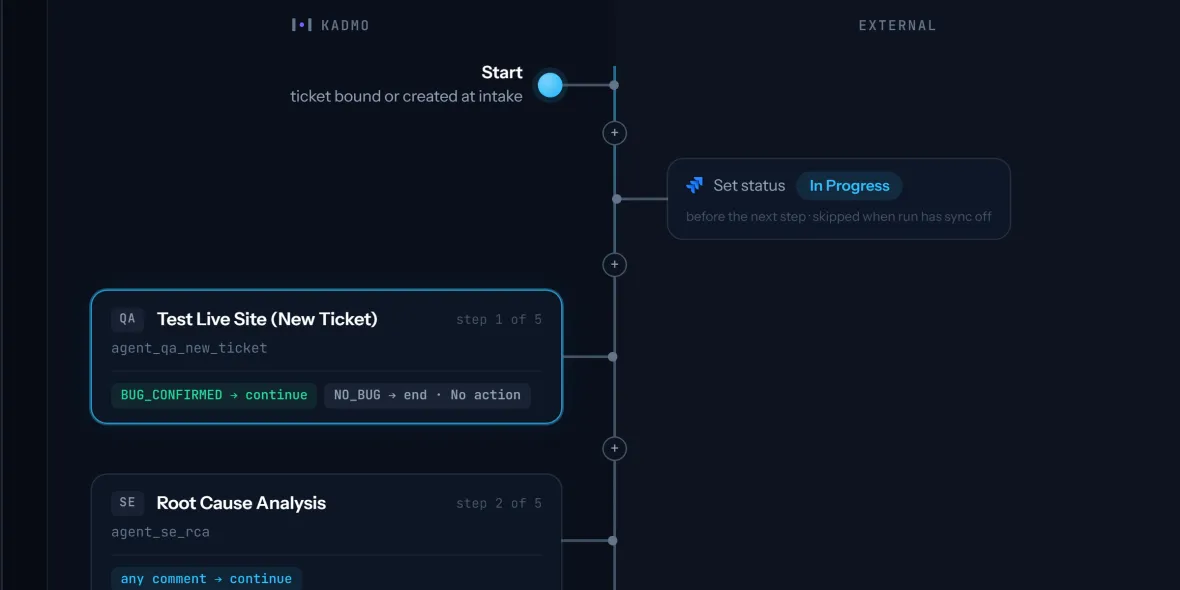
Ein Playbook ist ein vorgezeichneter Ablauf für eine wiederkehrende Aufgabe, etwa einen Bug Fix, ein Feature oder eine Dokumentationsseite. Es legt fest, aus welchen Schritten die Aufgabe besteht, welcher spezialisierte Agent jeden Schritt übernimmt und woran gemessen wird, ob der Schritt bestanden ist.
Spezialisiert heißt: der Agent hat eine Rolle. Eine Rolle ist kein Titel, sondern ein Bündel aus drei Dingen: ein fester Auftrag, das Wissen über die Software, das dieser Auftrag braucht, dazu der Zugriff auf die passenden Werkzeuge. Eine QA Rolle prüft und merged nicht, eine Senior Rolle merged und baut nicht. Welche Rollen es gibt, legt man selbst fest.
Das Vorbild ist ein Scrum Team. Eine Produktmanagerin bricht die Aufgabe auf, ein Entwickler baut, QA prüft gegen das laufende Produkt, ein Senior reviewt und merged. Niemand käme auf die Idee, alle vier Rollen in einen Kopf zu legen, weil Bauen und Prüfen unterschiedliche Blickwinkel brauchen. Bei Agenten gilt das genauso, nur dass hinter jeder Rolle ein eigener Agent auf einer eigenen Maschine steht, rund um die Uhr.
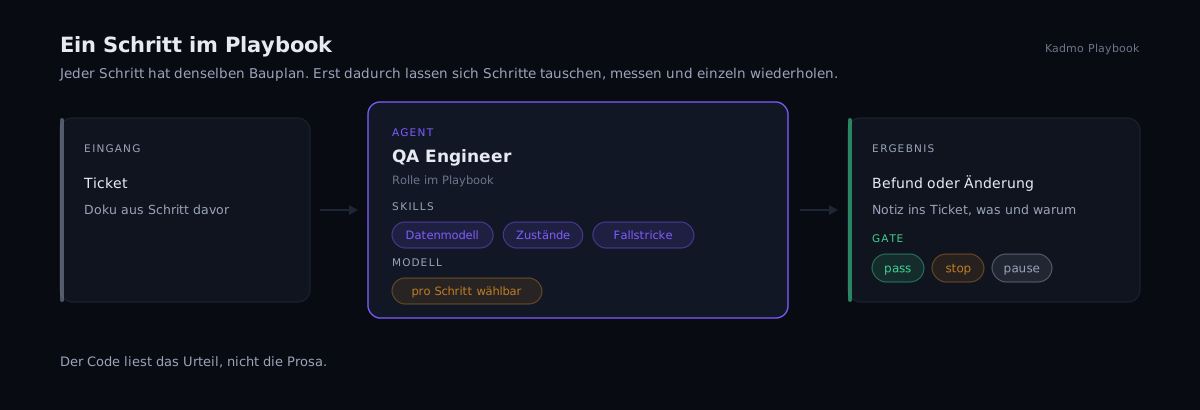
Der unscheinbare Teil, der das Ganze zusammenhält, ist die Dokumentation. Agenten sprechen nicht miteinander. Was Schritt eins herausgefunden hat, existiert für Schritt zwei nur dann, wenn es aufgeschrieben wurde. Das Ticket ist das gemeinsame Gedächtnis. Die Übergabe zwischen den Schritten ist die Stelle, an der ein schlecht gebautes Setup zuerst bricht.
Warum das Ergebnis besser wird
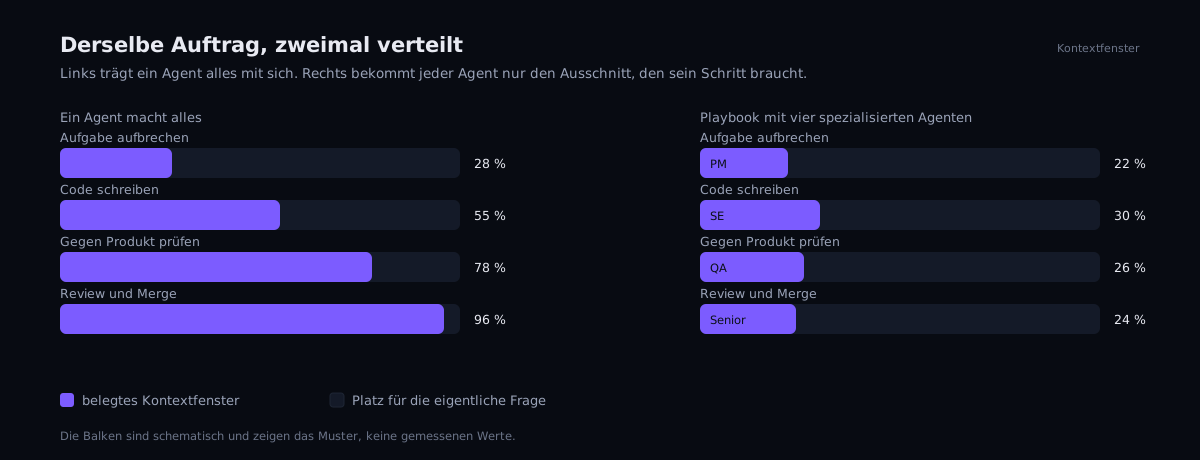
Der Kontext bleibt klein. Das Kontextfenster ist der limitierende Faktor jedes Sprachmodells. Die Trefferquote sinkt, je mehr Material darin liegt, das mit der aktuellen Frage nichts zu tun hat. Ein Alleskönner Agent schleppt am Ende einer Aufgabe die gesamte Historie mit sich herum. In einem Playbook bekommt jeder Agent nur das, was sein Schritt braucht.
Spezialisten arbeiten an ihrem Thema. Ein Agent in der QA Rolle sucht Fehler, einer in der Entwicklerrolle baut. Dass beide getrennt sind, ist kein organisatorisches Detail, sondern der Grund, warum das Prüfen überhaupt etwas findet. Wer seine eigene Arbeit prüft, prüft milder.
Gates statt Vertrauen. Jeder Schritt endet mit einem Urteil, das der Code liest: pass, stop oder pause. Das Gate kann von einem Agenten kommen oder von einem Menschen, je nachdem wie viel ein Fehler an dieser Stelle kostet. Wichtig ist, dass ein Problem dort stoppt, wo es entsteht, statt drei Schritte später im Review zu landen. Ein stop beendet dabei nicht die Aufgabe. Der Schritt geht zurück in den Ablauf und wird wiederholt, bis er sein Gate besteht.
Das passende Modell pro Schritt. Ein Schritt, der Text sortiert oder eine Datei einordnet, braucht kein Spitzenmodell. Ein Architekturentwurf dagegen schon. Weil jeder Schritt sein eigenes Modell haben kann, wird die Rechnung planbar. Erscheint nächste Woche ein besseres Modell, tauscht man es an der Stelle aus, an der es etwas bringt.
End to End ohne Bot sitting. Der Ablauf läuft von der Aufgabe bis zum Pull Request durch, ohne dass jemand daneben sitzt und nachsteuert. Menschen kommen an den Stellen dazu, an denen ihr Urteil zählt, nicht bei jedem Zwischenschritt.
Drei Punkte, die in solchen Listen meistens fehlen
Wiederholbar heißt messbar. Weil jede Aufgabe denselben Weg nimmt, entstehen Zahlen pro Schritt. Die Zahl, an der wir uns messen lassen, steht am Ende: 92,5 Prozent der von Agenten gelieferten Pull Requests werden im menschlichen Review angenommen. Innerhalb des Ablaufs sind Rückläufe dagegen normal und ausdrücklich gewollt. Genau dafür sind die Gates da. Dazu sehen wir, an welchem Schritt es klemmt. Ohne feste Schritte gäbe es weder das eine noch das andere zu messen.
Verbesserungen gelten ab sofort für alle. Wenn ein Entwickler seinen Prompt verfeinert, bleibt der Gewinn bei ihm. Wenn eine Regel ins Playbook wandert, gilt sie für jeden künftigen Lauf, auch für den, der nachts um drei startet. Dasselbe gilt für das Wissen über die eigene Software, das in den Skills der Agenten liegt und mit jedem Durchlauf genauer wird.
Fehler bleiben klein. Wenn ein Schritt scheitert, wird dieser Schritt wiederholt und nicht die ganze Aufgabe. Das klingt nach einem Detail, entscheidet aber darüber, ob ein Fehlschlag zehn Cent oder zehn Dollar kostet. Es entscheidet auch darüber, ob jemand den Lauf hinterher noch nachvollziehen kann.
Warum ein Prompt das nicht ersetzt
Man kann einen Agenten auch ohne Plattform bitten, nach einem festen Ablauf zu arbeiten und sich dafür Subagenten zu holen. In einer Demo sieht das oft gut aus. Der Unterschied liegt darin, was der Ablauf eigentlich ist. Im Prompt ist er eine Beschreibung, die das Modell bei jedem Lauf neu auslegt. Je länger eine Aufgabe dauert, desto wahrscheinlicher wandert der Agent ab. Er lässt einen Schritt aus, erklärt die Prüfung für erledigt, weil er beim Schreiben ja schon hingeschaut habe, oder er deutet den Auftrag unterwegs um.
In einem Playbook ist der Ablauf keine Bitte, sondern Konfiguration. Die Schritte, ihre Reihenfolge, die Gates und der Zugriff jedes Agenten liegen außerhalb des Modells fest. Was nicht vorgesehen ist, kann ein Agent nicht tun, weil ihm dafür die Werkzeuge fehlen. Im ersten Lauf fällt der Unterschied kaum auf. Im dreißigsten schon.
Was wir dabei gelernt haben
Der größte Hebel liegt nicht in besseren Prompts, sondern in der Übergabe. Ein Schritt, der sauber aufschreibt, was er getan hat und warum, macht den nächsten Schritt kürzer und das Review schneller. Umgekehrt frisst eine schlampige Übergabe den Vorteil wieder auf, den die Aufteilung gebracht hat.
Das zeigt sich in der Praxis deutlich. Eine Produktmanagerin hat mit einer Agent Fleet das Ticketvolumen von rund sieben Entwicklern geliefert. In unserem eigenen Team ist der Inhalt eines Zwei Wochen Sprints in zwei Tagen entstanden, bei besserer Qualität als vorher. Beides lief über Playbooks, nicht über einen besonders langen Prompt.
Wo man anfängt
Nicht beim schwierigsten Thema. Der erste Ablauf sollte einer sein, um den sich im Team ohnehin niemand reißt und bei dem niemand um seinen Status fürchtet: Dokumentation, QA oder eine Migration. Dort lässt sich in zwei Wochen sehen, ob der Ablauf trägt. Das Team erlebt den Nutzen, bevor es über die Feature Entwicklung diskutiert.
Bei Kadmo arbeiten spezialisierte Agenten nach solchen Playbooks, auf eurer eigenen Infrastruktur und mit jedem LLM, jederzeit austauschbar. Wenn ihr sehen wollt, wie das bei euch aussehen kann, zeigen wir es euch gern.